— エッジAI 実装の勘所 —
「開発環境ではNVIDIAのGPUで動いていたモデルを、現場向けにNPU搭載機へ載せ替えようとしたら、思ったように進まない」。エッジAIの導入現場でよく聞く話です。学習済みモデルという同じ資産を使うのだから、変換すれば動くはずだ——という期待と、実際の作業量にはかなりの開きがあります。
本記事では、GPU環境で開発したモデルをエッジ向けNPUへ移植する際に、どこでつまずきやすく、どういう順序で進めれば見通しが立つのかを整理します。
1. なぜ移植が必要になるのか
そもそも、なぜGPUのまま現場に持ち込まないのかを確認しておきます。理由は主に3つです。
-
消費電力と発熱 GPUは高性能ですが電力を要します。盤内設置・ファンレスといった現場条件では、数ワット級で推論できるNPUが選択肢になります
-
サイズと設置性 現場に置けるのは小型・低発熱の筐体です。設置スペースと放熱の制約が構成を決めます
-
長期供給とコスト 量産機に組み込む場合、数年単位で同一構成を調達できるかが重要になります
つまり移植は「性能を落とす作業」ではなく、現場条件という制約のもとで実用的な構成に載せ替える作業です。この位置づけを共有しておくと、社内の期待値もそろいます。
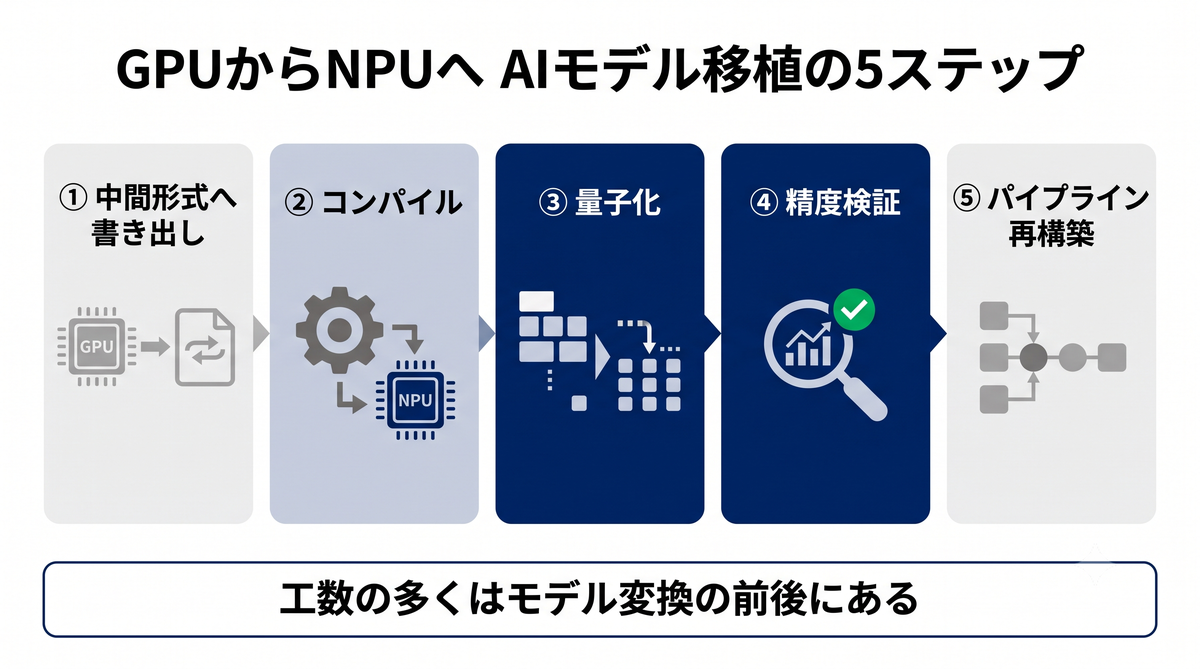
2. 移植の全体像 ── 5つのステップ
ベンダーやツールが違っても、移植の流れはおおむね共通しています。
-
中間形式への書き出し 学習時のフレームワーク(PyTorch等)から、ONNXなどの中間形式へエクスポートする
-
ターゲット向けコンパイル NPUベンダーのコンパイラで、そのハードウェア専用の実行形式へ変換する
-
量子化 多くの場合FP32からINT8へ落とす。ここで精度が変わる可能性がある
-
精度検証 変換前後で、自社データに対する精度を突き合わせる
-
パイプライン再構築と性能計測 前後処理・デコード・描画まで含めた実行環境を組み直し、実際のスループットを測る
経験上、作業量が読みにくいのは③④と⑤です。①②は手順が公開されており比較的見通しが立ちますが、③以降は自社モデル・自社データに依存するため、事前見積もりが難しくなります。
3. つまずきどころ① 未対応オペレータ
最初に出会う壁がこれです。NPUはハードウェアで実装された演算しか高速に処理できないため、モデル内に対応していない演算(オペレータ)が含まれていると、そこで変換が止まるか、CPU側にフォールバックします。
フォールバック自体は動作こそしますが、CPUとNPUの間を行き来するぶん処理が遅くなり、せっかくの推論性能が出ません。「変換は通ったのに速くならない」という現象の典型的な原因です。
対処の方向性は2つです。ひとつはモデル側を作り変えること(該当層を対応済みの演算で置き換える、あるいはベンダーが提供するModel Zooの構造に寄せる)。もうひとつは後処理として切り出すことです。NMSのような後処理をモデルグラフの外に出し、CPU側で実装するほうが素直な場合もあります。
ここで重要なのは、移植の初期段階でオペレータの対応状況を確認しておくことです。学習をやり直したあとに未対応が判明すると手戻りが大きくなります。
4. つまずきどころ② 量子化と精度
エッジ向けNPUの多くはINT8での推論を前提としています。FP32で学習したモデルをINT8へ落とすため、原理的には精度が変わり得ます。
実務でよく使われるのは、学習後に代表データを流して量子化パラメータを決める手法(Post-Training Quantization、PTQ)です。再学習を伴わないため導入しやすい一方、与える代表データ(キャリブレーションデータ)の選び方が結果を左右します。本番と分布の異なるデータを使うと、検証環境では良く見えても現場で精度が落ちる、ということが起こります。
なお、アーキテクチャによってはINT8でFP32と同等の精度を狙える設計を打ち出しているものもあります。たとえばAxelera AIのMetis AIPUは、INT8でFP32同等の精度を再学習なしで得られることを特徴として挙げています。ただしこれはモデル・データに依存する話でもあるため、自社データでの検証は必ず行うという原則は変わりません。
精度検証の実務としては、次を押さえます。
-
変換前後で同じ評価データセット・同じ指標で比較する(平均精度だけでなく、見逃しと誤検知を分けて見る)
-
現場で問題になるのは往々にして特定条件下での劣化。暗所・逆光・特定の不良種など、条件別に分けて確認する
-
許容ラインを移植前に決めておく(「元モデル比で何ポイントまでなら可とするか」)
5. つまずきどころ③ 前後処理とパイプライン
見落とされやすいのがここです。モデル本体が載っても、その周辺の処理は作り直しになることがほとんどです。
具体的には、カメラ入力の取得、デコード、リサイズ・正規化などの前処理、推論結果の後処理、描画や出力です。GPU環境ではこれらをGPU側でまとめて処理していたものが、NPU構成ではCPUに戻ってくることがあり、CPUがボトルネックになるという事態が起こります。
特に映像を扱う場合、デコード処理の負荷は無視できません。ソフトウェアデコードに頼るとCPU使用率が跳ね上がるため、ハードウェアデコード機能の有無と、その処理を含めた全体の設計が実効性能を決めます。
ベンダー各社は、この周辺処理を含めたパイプラインを構築するためのフレームワークを提供しています。HailoではTAPPAS、Axelera AIではVoyager SDKが、いずれもGStreamerをベースにしたパイプライン構築の仕組みを持っています。移植の工数を見積もるときは、モデル変換だけでなくこのパイプライン再構築ぶんを必ず入れてください。
なお、開発中・実験的な位置づけのAPIが含まれる場合があります(Axelera AIのPipeline Builder APIは現状Alpha=実験的と位置づけられています)。本番採用の前に、使用するAPIの成熟度を確認しておくことをおすすめします。
6. つまずきどころ④ 性能を「本番条件で」測る
単一画像に対する推論時間だけを見て「速い」と判断すると、現場で期待外れになります。測るべきは、本番のカメラ台数・解像度・フレームレートで、前後処理を含めた実効スループットです。
あわせて、連続稼働時の温度上昇による性能低下(サーマルスロットリング)も確認します。PoCの短時間試験では出ず、本番の連続運転で顕在化する典型的な問題です。
7. 進め方の提案 ── 小さく確かめてから広げる
ここまでの内容を踏まえた、現実的な進め方をまとめます。
-
先にオペレータ対応を確認する 自社モデルの構造をベンダー資料・Model Zooと突き合わせ、変換可能性の見通しを立てる
-
小さいモデル・少数データで一周させる 変換→量子化→推論までを一度通し、ツールチェーンの癖をつかむ
-
精度の許容ラインを合意する 技術部門と現場部門で、移植前に基準を決めておく
-
パイプラインを本番構成で組む カメラ・台数・解像度を本番に合わせ、CPU負荷を含めて計測する
-
連続運転で確かめる 温度・メモリ・処理落ちを、時間をかけて観察する
自動車部品や金属加工のように、同じ検査ラインを複数拠点へ横展開する用途では、この移植作業を1回で終わらせて水平展開できるかが投資対効果を大きく左右します。最初の1ラインで構成を固め、以降は同一構成を複製していく——という設計にしておくと、2ライン目以降の立ち上げがはるかに楽になります。
おわりに
GPUからNPUへのモデル移植でつまずくポイントを整理すると、次のようになります。未対応オペレータによる変換失敗やCPUフォールバック。INT8量子化に伴う精度変化と、キャリブレーションデータの選び方。前後処理・デコードを含むパイプラインの作り直しと、そこで生じるCPUボトルネック。そして本番条件・連続運転での性能計測。モデル変換そのものは移植作業の一部分にすぎず、工数の多くはその前後にあります。
移植の可否判断、対象NPUの選定、移植後の構成設計については、下記からお気軽にご相談ください。
